
Эта статья описывает метод чтения TAR-архивов (включая .tar.gz и .tar.bz2) в C++ с использованием Boost IOStreams.
Вы можете использовать для этого libtar, но оригинальная версия не обновлялась с 2003 года и не предоставляет вам гибкости и понимания внутренней структуры TAR-архива.
Я настоятельно рекомендую внимательно прочитать английскую статью Wikipedia и руководство по формату GNU TAR перед чтением этого поста.
Почему программирование TAR отстой
С точки зрения пользователя Linux, TAR — это здорово. Использование TAR повсеместно, и оно работает — вы можете не только архивировать терабайты данных простой командой, tar позволяет вам самостоятельно выбрать лучший метод сжатия.
Программный доступ к TAR-архивам, однако, не так прост.
На первый взгляд TAR кажется довольно простым. Всё хранится в блоках постоянного размера по 512 байт, каждое поле заголовка имеет постоянную длину, и вам не нужно сохранять какое-либо состояние между разными заголовками.
Для самого базового случая это действительно работает, но в реальном мире это никогда не работает, как ожидалось. * Нет ‘единой’ спецификации TAR, но есть ‘базовый’ tar, USTAR, и вендор-специфичные (GNU) расширения к нему * Базовый TAR поддерживает только макс. 100 символов в именах файлов. GNU TAR и USTAR поддерживают расширенные имена файлов * TAR-файлы могут содержать не только файлы и директории, но также символические ссылки, жёсткие ссылки, символьные устройства, блочные устройства, FIFO, разреженные файлы… * Согласно Wikipedia, разрешение временной метки нигде не определено
Структура записи TAR
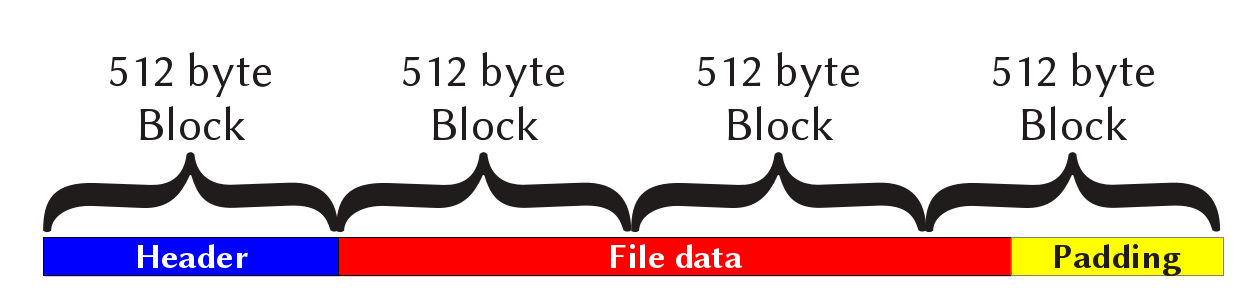
Диаграмма выше показывает структуру одной записи TAR. TAR-файл — это просто последовательность записей этого формата.
512-байтовый заголовок файла всегда записывается перед данными файла — это даёт более простую структуру программы, потому что позволяет вам читать файл последовательно без необходимости сохранять информацию между записями. В некоторой степени этот метод также необходим для записи файлов на магнитные или оптические ленты, где данные должны записываться последовательно.
ZIP-файлы не следуют этой концепции — они имеют центральный каталог в конце файла. Вы не можете читать данные последовательно, но, в отличие от TAR, вы можете добавлять или удалять файлы без необходимости переписывать весь архив.
Заголовок содержит поле размера файла, определяющее длину файла. Бинарные данные файла непосредственно следуют за заголовком. Чтобы сохранить 512-байтовую блочную структуру, последний блок дополняется NUL-символами, если только размер файла не делится на 512.
В некоторых случаях — директории, например — поле размера заголовка установлено в ноль, и следующий блок является другим заголовком.
Декодирование TAR восьмеричных чисел
Все числа, особенно размеры файлов, в заголовке кодированы как восьмеричные числа с завершающими нулями в TAR. Цифры представлены как ASCII-символы.
Кроме того, восьмеричные числа могут (но не обязаны) содержать завершающие NUL.
Реализация этого не дала правильных результатов, мне пришлось интерпретировать символ непосредственно слева от крайнего левого NUL (или пробела) как наименее значимую цифру, чтобы воспроизвести размеры файлов, полученные tar tzvf archive.tar.gz (GNU TAR 1.26 использовался во время тестирования).
#define ASCII_TO_NUMBER(num) ((num)-48) //Преобразует ASCII-цифру в соответствующее число

/**
 * Декодирует восьмеричное число TAR.
 * Игнорирует всё после первого символа NUL или пробела.
 * @param data Указатель на восьмерично-кодированное поле длиной size байт
 * @param size Размер поля, на которое указывает указатель data
 * @return
 */
static uint64_t decodeTarOctal(char* data, size_t size = 12) {
    unsigned char* currentPtr = (unsigned char*) data + size;
    uint64_t sum = 0;
    uint64_t currentMultiplier = 1;
    //Пропускаем всё после последнего символа NUL/пробела
    //В некоторых TAR-архивах поле размера содержит NUL/пробелы не только в конце, поэтому это необходимо
    unsigned char* checkPtr = currentPtr; //Используется для проверки, где находится последний символ NUL/пробел
    for (; checkPtr >= (unsigned char*) data; checkPtr--) {
        if ((*checkPtr) == 0 || (*checkPtr) == ' ') {
            currentPtr = checkPtr - 1;
        }
    }
    for (; currentPtr >= (unsigned char*) data; currentPtr--) {
        sum += ASCII_TO_NUMBER(*currentPtr) * currentMultiplier;
        currentMultiplier *= 8;
    }
    return sum;
}Структура данных заголовка
Хотя технически возможно поддерживать классический формат tar, почти в любом случае использования это не нужно, так как формат USTAR (вводящий дополнительные флаги заголовка) стандартизирован почти 25 лет и практически любой tar должен его поддерживать.
Эта страница предоставляет оригинальную C-структуру star (разновидности tar) для заголовка TAR, но в C++ мы можем добавить функции-члены, например, для декодирования размера файла, в неё. Это улучшает удобство использования класса.
struct TARFileHeader {
    char filename[100]; //Завершается NUL
    char mode[8];
    char uid[8];
    char gid[8];
    char fileSize[12];
    char lastModification[12];
    char checksum[8];
    char typeFlag; //Также называется индикатором ссылки для формата не-UStar
    char linkedFileName[100];
    //Поля, специфичные для UStar -- заполнены NUL в версии, отличной от USTAR
    char ustarIndicator[6]; //"ustar" -- 6-й символ может быть NUL, но результаты показывают, что это не обязательно
    char ustarVersion[2]; //00
    char ownerUserName[32];
    char ownerGroupName[32];
    char deviceMajorNumber[8];
    char deviceMinorNumber[8];
    char filenamePrefix[155];
    char padding[12]; //Ничего интересного, но важно для контрольной суммы

    /**
     * @return true, если и только если
     */
    bool isUSTAR() {
        return (memcmp("ustar", ustarIndicator, 5) == 0);
    }

    /**
     * @return Размер файла в байтах
     */
    size_t getFileSize() {
        return decodeTarOctal(fileSize);
    }

    /**
     * Возвращает true, если и только если контрольная сумма заголовка корректна
     * @return
     */
    bool checkChecksum() {
        //Нам нужно обнулить контрольную сумму
        char originalChecksum[8];
        memcpy(originalChecksum, checksum, 8);
        memset(checksum, ' ', 8);
        //Вычисляем контрольную сумму -- как знаковую, так и беззнаковую
        int64_t unsignedSum = 0;
        int64_t signedSum = 0;
        for (int i = 0; i < sizeof (TARFileHeader); i++) {
            unsignedSum += ((unsigned char*) this)[i];
            signedSum += ((signed char*) this)[i];
        }
        //Копируем контрольную сумму обратно
        memcpy(checksum, originalChecksum, 8);
        //Декодируем исходную контрольную сумму
        uint64_t referenceChecksum = decodeTarOctal(originalChecksum);
        return (referenceChecksum == unsignedSum || referenceChecksum == signedSum);
    }
};Сборка частей вместе
Единственное, что осталось сделать — обработать сам TAR-файл.
Следующая программа читает TAR-файл, перечисляет его содержимое и загружает каждый файл в память. Печатаются имена файлов и директорий.
Если у вас есть предложения по улучшению или вы нашли баг, пожалуйста, прокомментируйте!
Эта реализация поддерживает * GNU-специфичное расширение длинных имён файлов * USTAR расширение префикса имени файла * Подписанные и беззнаковые вычисления контрольной суммы (не активно по умолчанию) * Проверку флага USTAR (не активна по умолчанию) * NUL-заполненный маркер конца блока (вместо EOF) * .tar.gz и .tar.bz2 плюс автоопределённую декомпрессию * Использует boost::iostreams, так что вы можете легко заменить файловый ввод на что угодно вообразимое, например, TCP-поток
Эта реализация явно не поддерживает (хотя может и не упасть):
- Любой тип файла, кроме обычных файлов и директорий (включая символические ссылки)
- Большие файлы
- Любые расширения, не перечисленные здесь
- Обширные модульные тесты (могут быть добавлены когда-нибудь в будущем, но не ждите этого)
- ANSI-C реализацию. Это может быть возможно, но декомпрессия не настолько plug-and-play, как с boost::iostreams.
Полный исходный код:
/**
* Чтение TAR-файла в C++
* Пример кода
*
* (C) Uli Köhler 2013
* Лицензия CC-By 3.0 Germany: http://creativecommons.org/licenses/by/3.0/de/legalcode
*
* Компиляция:
* g++ -o cpptar cpptar.cpp -lboost_iostreams -lz -lbz2
*/
#include <cstdlib>
#include <cassert>
#include <cstdio>
#include <fstream>
#include <cmath>
#include <iostream>
#include <boost/iostreams/device/file.hpp>
#include <boost/iostreams/filtering_stream.hpp>
#include <boost/iostreams/filter/gzip.hpp>
#include <boost/iostreams/filter/bzip2.hpp>
//Проверка расширений файлов
#include <boost/algorithm/string.hpp>
using namespace std;
using namespace boost::iostreams;
#define ASCII_TO_NUMBER(num) ((num)-48) //Преобразует ASCII-цифру в соответствующее число (предполагается, что это ASCII-цифра)
/**
* Декодирует восьмеричное число TAR.
* Игнорирует всё после первого символа NUL или пробела.
* @param data Указатель на восьмерично-кодированное поле длиной size байт
* @param size Размер поля, на которое указывает указатель data
* @return
*/
static uint64_t decodeTarOctal(char* data, size_t size = 12) {
unsigned char* currentPtr = (unsigned char*) data + size;
uint64_t sum = 0;
uint64_t currentMultiplier = 1;
//Пропускаем всё после последнего символа NUL/пробела
//В некоторых TAR-архивах поле размера содержит NUL/пробелы не только в конце, поэтому это необходимо
unsigned char* checkPtr = currentPtr; //Используется для проверки, где находится последний символ NUL/пробел
for (; checkPtr >= (unsigned char*) data; checkPtr--) {
if ((*checkPtr) == 0 || (*checkPtr) == ' ') {
currentPtr = checkPtr - 1;
}
}
for (; currentPtr >= (unsigned char*) data; currentPtr--) {
sum += ASCII_TO_NUMBER(*currentPtr) * currentMultiplier;
currentMultiplier *= 8;
}
return sum;
}
struct TARFileHeader {
char filename[100]; //Завершается NUL
char mode[8];
char uid[8];
char gid[8];
char fileSize[12];
char lastModification[12];
char checksum[8];
char typeFlag; //Также называется индикатором ссылки для формата не-UStar
char linkedFileName[100];
//Поля, специфичные для UStar -- заполнены NUL в версии, отличной от USTAR
char ustarIndicator[6]; //"ustar" -- 6-й символ может быть NUL, но результаты показывают, что это не обязательно
char ustarVersion[2]; //00
char ownerUserName[32];
char ownerGroupName[32];
char deviceMajorNumber[8];
char deviceMinorNumber[8];
char filenamePrefix[155];
char padding[12]; //Ничего интересного, но важно для контрольной суммы
/**
* @return true, если и только если
*/
bool isUSTAR() {
return (memcmp("ustar", ustarIndicator, 5) == 0);
}
/**
* @return Размер файла в байтах
*/
size_t getFileSize() {
return decodeTarOctal(fileSize);
}
/**
* Возвращает true, если и только если контрольная сумма заголовка корректна
* @return
*/
bool checkChecksum() {
//Нам нужно обнулить контрольную сумму
char originalChecksum[8];
memcpy(originalChecksum, checksum, 8);
memset(checksum, ' ', 8);
//Вычисляем контрольную сумму -- как знаковую, так и беззнаковую
int64_t unsignedSum = 0;
int64_t signedSum = 0;
for (int i = 0; i < sizeof (TARFileHeader); i++) {
unsignedSum += ((unsigned char*) this)[i];
signedSum += ((signed char*) this)[i];
}
//Копируем контрольную сумму обратно
memcpy(checksum, originalChecksum, 8);
//Декодируем исходную контрольную сумму
uint64_t referenceChecksum = decodeTarOctal(originalChecksum);
return (referenceChecksum == unsignedSum || referenceChecksum == signedSum);
}
};
int main(int argc, char** argv) {
if (argc < 2) {
cerr << "Usage: " << argv[0] << " <TAR archive>" << endl;
return 1;
}
ifstream fin(argv[1], ios_base::in | ios_base::binary);
filtering_istream in;
//В зависимости от формата сжатия выбираем правильный декомпрессор
string filename(argv[1]);
if (boost::algorithm::iends_with(filename, ".gz")) {
in.push(gzip_decompressor());
} else if (boost::algorithm::iends_with(filename, ".bz2")) {
in.push(bzip2_decompressor());
} else if (boost::algorithm::iends_with(filename, ".tar")) {
//Фильтр декомпрессии не нужен
} else {
cerr << "Unknown file suffix: " << filename << endl;
return 1;
}
in.push(fin);
//Инициализируем заполненный нулями блок для сравнения (заполненный нулями блок заголовка --> конец TAR-архива)
char zeroBlock[512];
memset(zeroBlock, 0, 512);
//Начинаем чтение
bool nextEntryHasLongName = false;
while (in) { //Останавливаемся, если достигнут конец файла или произошла любая ошибка
TARFileHeader currentFileHeader;
//Читаем заголовок файла.
in.read((char*) ¤tFileHeader, 512);
//Когда найден блок, состоящий только из нулей, TAR-архив заканчивается здесь
if(memcmp(¤tFileHeader, zeroBlock, 512) == 0) {
cout << "Found TAR end\n";
break;
}
//Раскомментируйте это для проверки всех контрольных сумм заголовков
//Кажется, в интернете есть TAR-файлы, в которых отдельные заголовки не соответствуют контрольной сумме, даже если большинство заголовков соответствуют.
//Это может указывать на ошибку в коде.
//assert(currentFileHeader.checkChecksum());
//Раскомментируйте это для проверки USTAR, если вам нужны функции USTAR
//assert(currentFileHeader.isUSTAR());
//Преобразуем имя файла в std::string для упрощения обработки
//Имена файлов длиной 100+ требуют специальной обработки
// (только USTAR поддерживает имена файлов длиной 101+ символов, но в архивах, отличных от USTAR, префикс равен 0 и поэтому игнорируется)
string filename(currentFileHeader.filename, min((size_t)100, strlen(currentFileHeader.filename)));
//---Удалите следующий блок, если вы не хотите поддерживать длинные имена файлов---
size_t prefixLength = strlen(currentFileHeader.filenamePrefix);
if(prefixLength > 0) { //Если есть префикс имени файла, добавляем его к строке. См. `man ustar`LON
filename = string(currentFileHeader.filenamePrefix, min((size_t)155, prefixLength)) + "/" + filename; //ограничение min: Не требуется спецификацией, но мы хотим быть в безопасности
}
//Игнорируем директории, обрабатываем только обычные файлы (символические ссылки в настоящее время полностью игнорируются и могут вызывать ошибки)
if (currentFileHeader.typeFlag == '0' || currentFileHeader.typeFlag == 0) { //Обычный файл
//Обработка длинных имён файлов GNU TAR -- текущий блок содержит только имя файла, тогда как следующий блок содержит метаданные
if(nextEntryHasLongName) {
//Устанавливаем имя файла из текущего заголовка
filename = string(currentFileHeader.filename);
//Следующий заголовок содержит метаданные, поэтому заменяем заголовок перед чтением метаданных
in.read((char*) ¤tFileHeader, 512);
//Сбрасываем флаг длинного имени
nextEntryHasLongName = false;
}
//Теперь метаданные в текущем заголовке файла корректны -- мы можем читать значения.
size_t size = currentFileHeader.getFileSize();
//Записываем в лог, что найден файл
cout << "Found file '" << filename << "' (" << size << " bytes)\n";
//Читаем файл в память
// Это не будет работать для очень больших файлов -- используйте потоковые методы!
char* fileData = new char[size + 1]; //+1: Добавляем завершающий NUL, чтобы можно было интерпретировать файл как cstring (можно удалить, если не используется)
in.read(fileData, size);
//-------Поместите код для обработки содержимого файла здесь---------
delete[] fileData;
//В tar-архиве для каждого файла используются целые 512-байтовые блоки
//Поэтому теперь нам нужно пропустить дополняющие байты.
size_t paddingBytes = (512 - (size % 512)) % 512; //Какой длины должно быть дополнение до 512 байт
//Просто игнорируем дополнение
in.ignore(paddingBytes);
//----Удалите ветки else if и else, если вы хотите обрабатывать только обычные файлы---
} else if (currentFileHeader.typeFlag == '5') { //Директория
//В настоящее время длинные имена директорий обрабатываются некорректно
cout << "Found directory '" << filename << "'\n";
} else if(currentFileHeader.typeFlag == 'L') {
nextEntryHasLongName = true;
} else {
//Ни обычный файл, ни директория (символическая ссылка и т.д.) -- в настоящее время игнорируется без уведомления
cout << "Found unhandled TAR Entry type " << currentFileHeader.typeFlag << "\n";
}
}
//Очистка
fin.close();
}